让 GPT-6 Astra 写 Blender 脚本,把一帧画面搭成可交互的 3D 房间
写脚本 → 渲染 → 对照参考打分 → 修改,自动循环 10 轮;搭好的场景再当作“证据”喂给 SolarWM-H3
后续:能改吗?能动吗?这个场景改材质、改朝向、一句话换家具,用来做视频编辑,以及把动态内容也建模 →结论速览
- 通路跑通了。Astra 只写脚本(几何、材质、灯光),相机锁成 H3 第 0 帧的相机,所以每一轮渲染都能和参考帧逐像素对照、自动打分。10 轮里有 2 轮脚本报错,报错信息原样反馈后,下一轮就能修好。
- 搭出的是完整的 3D 房间,不只是在参考视角下“看起来像”。参考帧里看不到的部分(床的后半截、侧墙、门)都补全了。每个物体拆成带名字的部件(床腿、抽屉、把手、窗框……),并标了能否移动和质量,可以直接放进物理仿真。
- 物理检查抓到了图像指标看不出的错误。IoU 最高的一版(0.828)里,右边床头柜的腿交叉斜放,一放就倒(1 秒内倾斜 81°)。把静置测试加进反馈后,Astra 下一轮就把四条腿挪回了柜体下面。
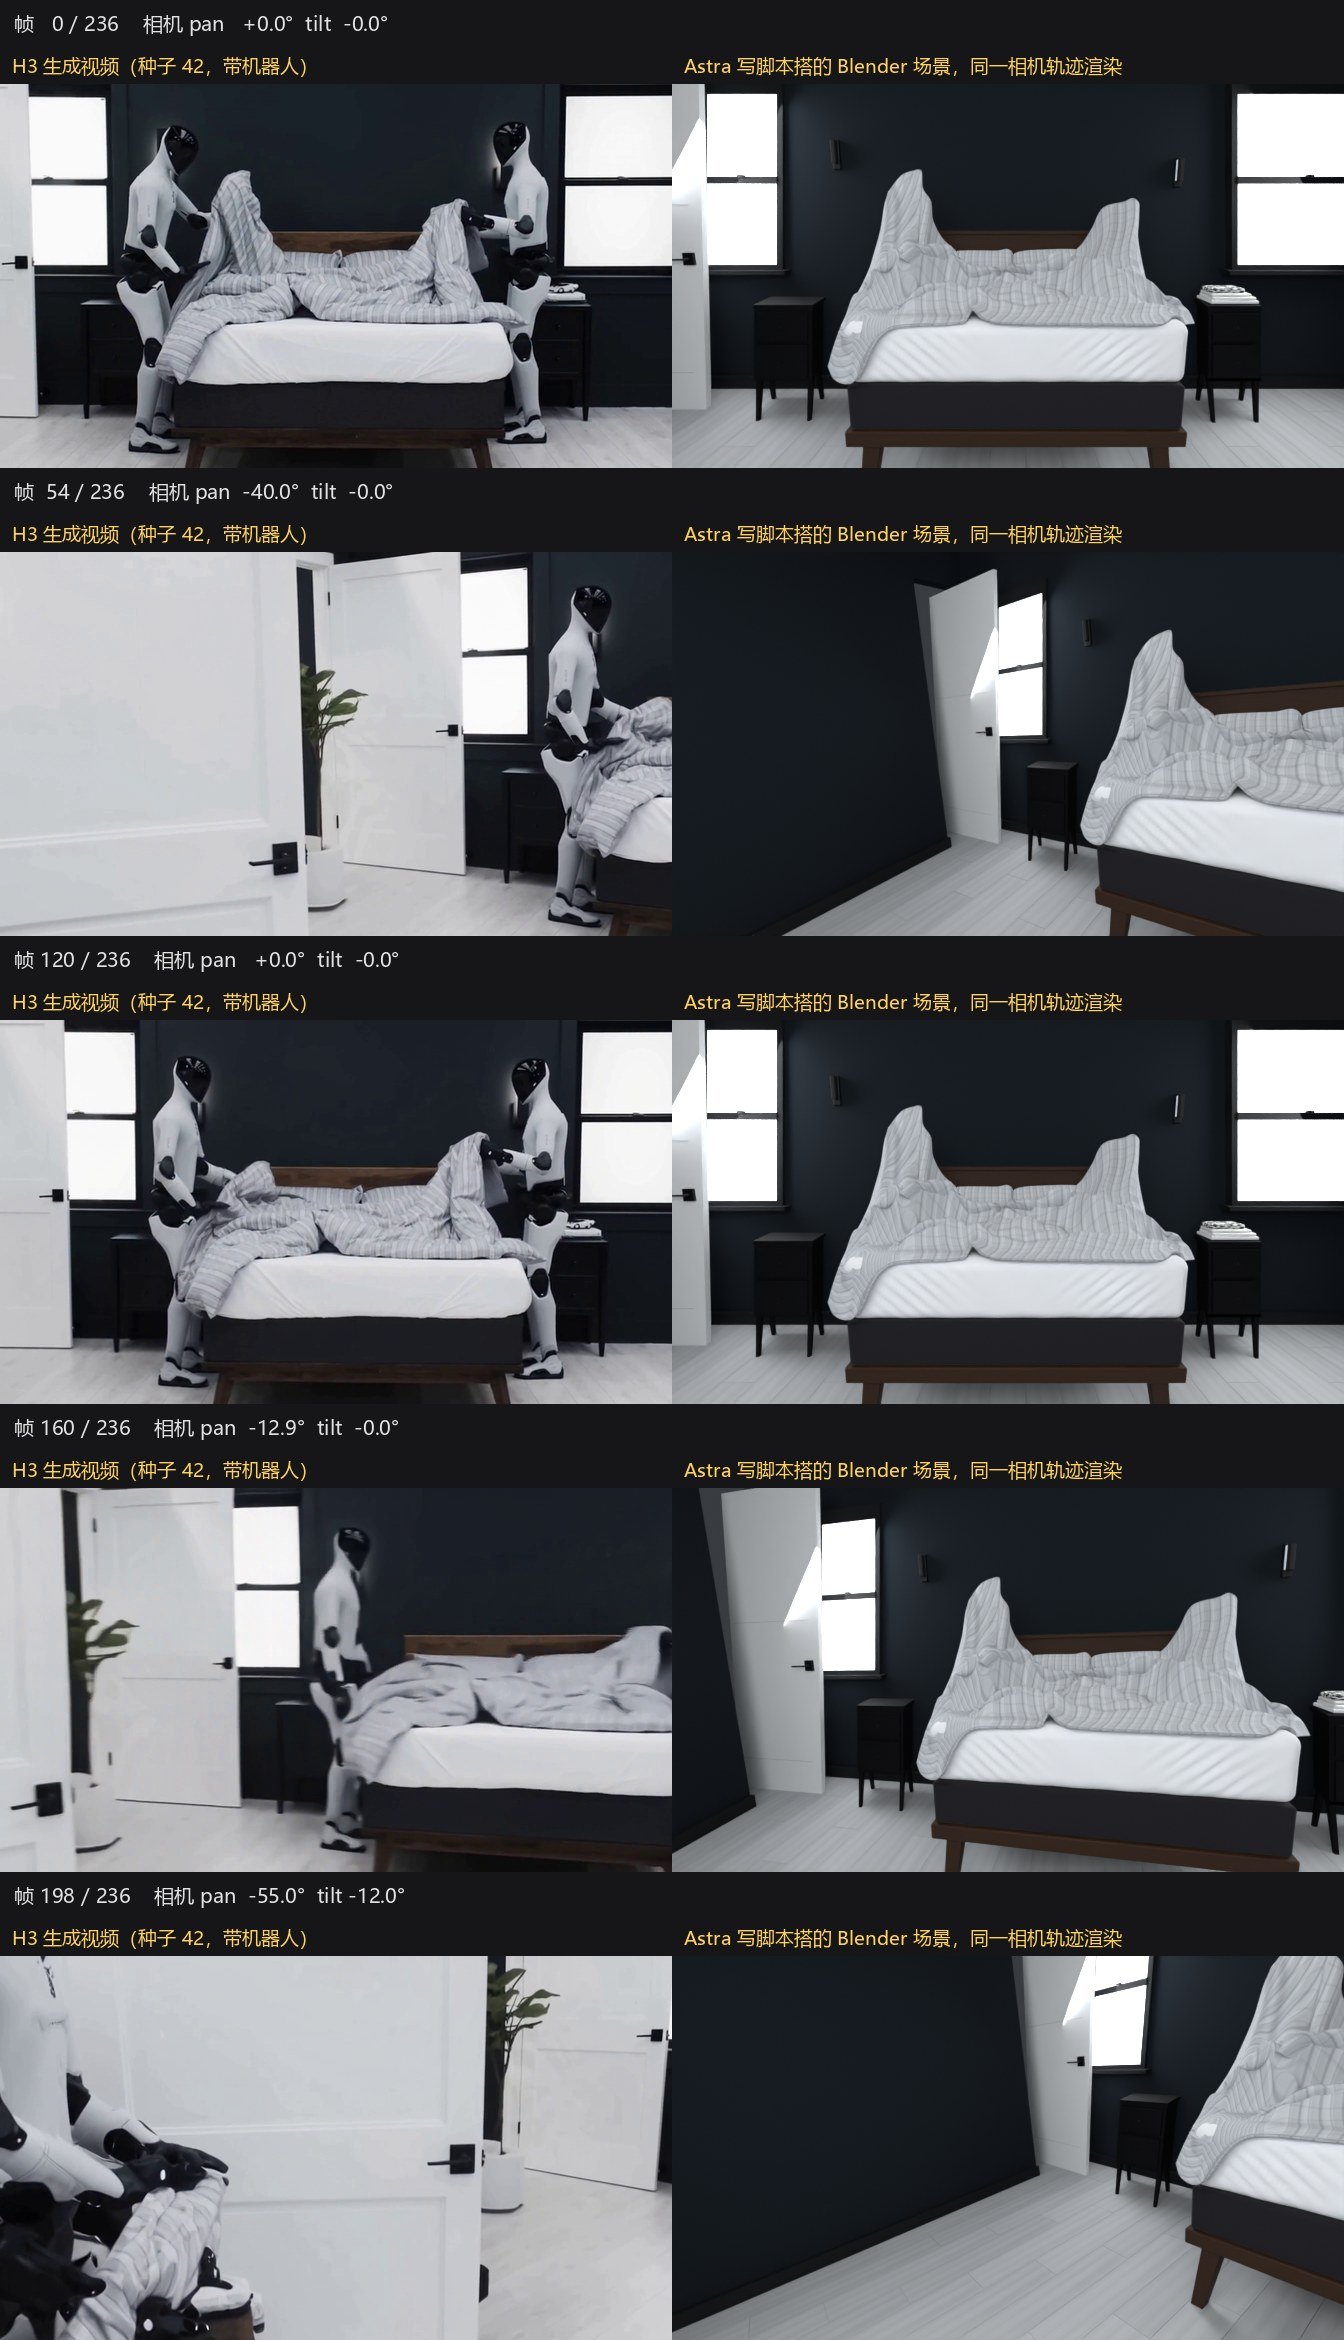
- 接入 H3 后,H3 会严格跟随三维场景。用 Blender 渲染的画面当证据,镜头大角度转回来时,画面和 Blender 场景一致。但这个场景只根据第 0 帧搭建:H3 在第一次访问时按提示词画出的门和植物不在场景里,回访时就被抹掉了(见下文更正)。
- 但证据太强,机器人消失了。只要证据覆盖画面的大部分,从第 68 帧(开始注入证据)起两个机器人就不见了;把机器人区域和被子排除在证据外也一样。下一步要控制证据强度。
参考帧 vs Blender 渲染(左右拖动对比)
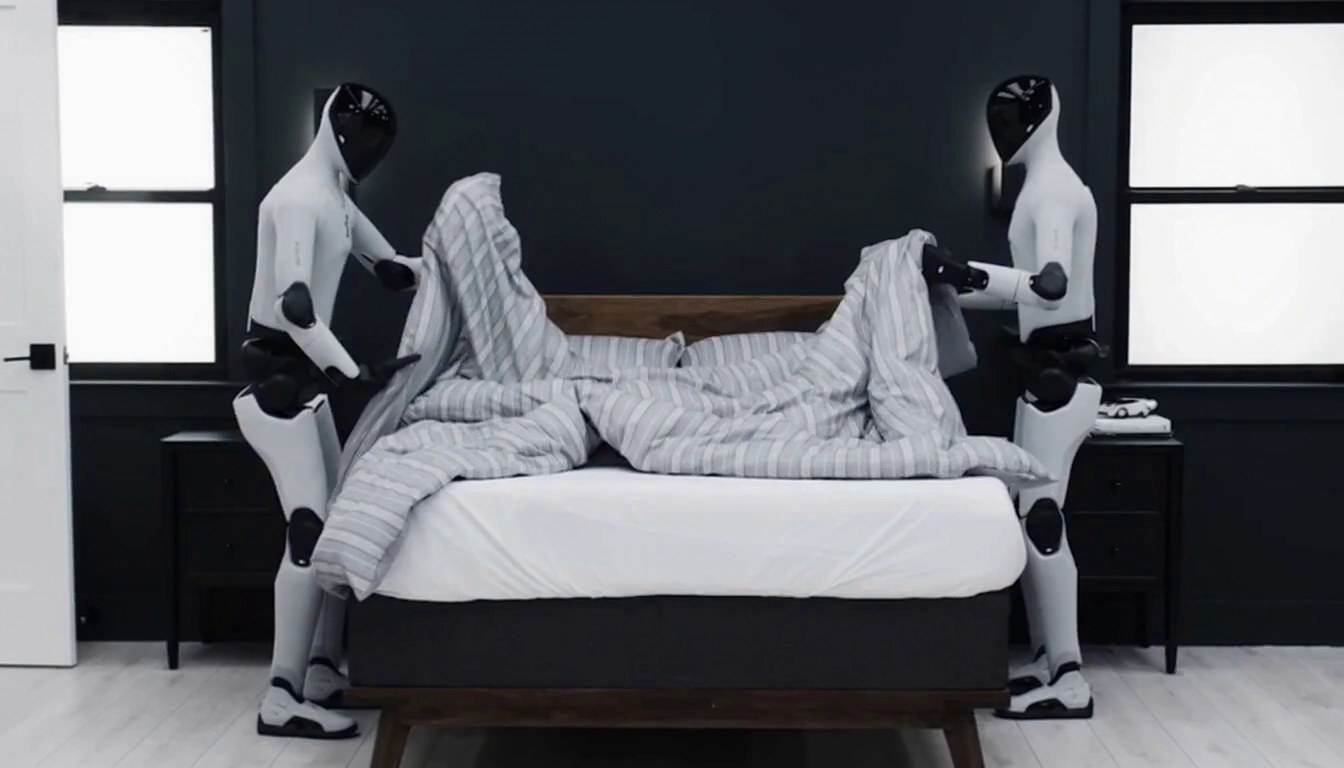
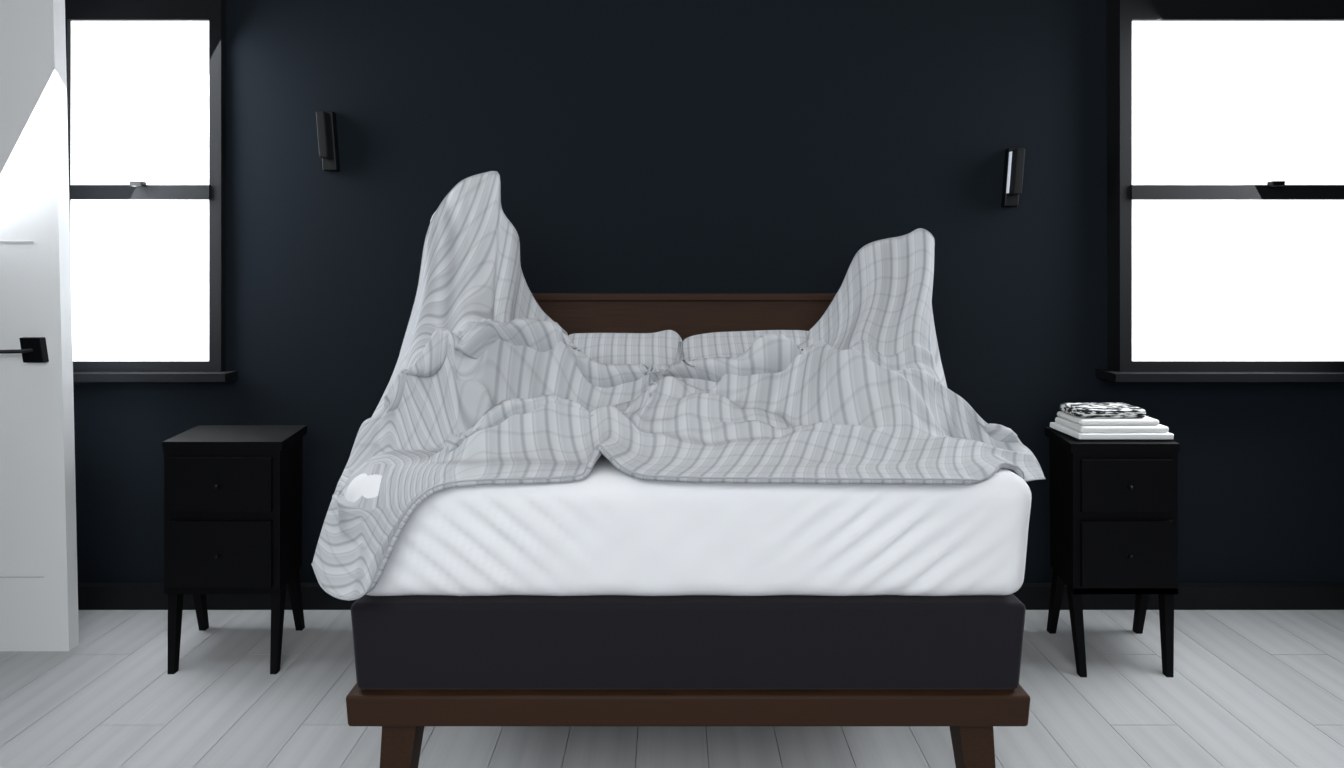 Blender(Astra 搭建)H3 第 0 帧(参考)
左:Astra 写脚本搭出的场景,用 H3 第 0 帧的相机内外参在 Blender 里渲染。右:H3 第 0 帧。两个机器人是动态角色,按要求不建模,位置留空。
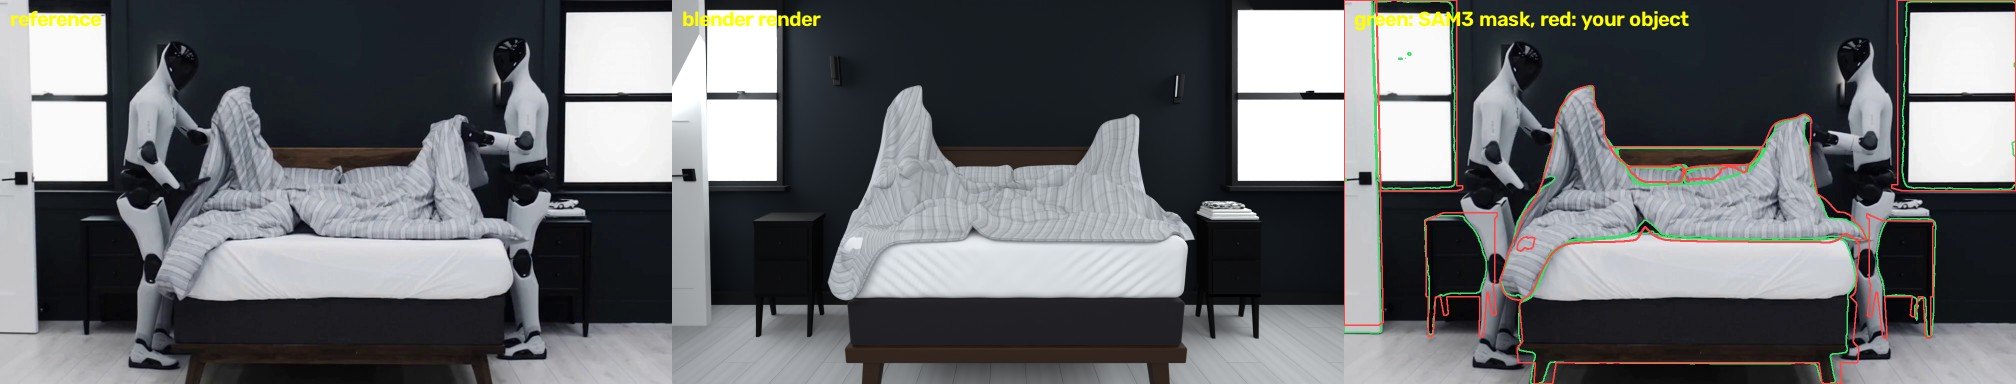
每个物体的 IoU。枕头大半被被子盖住、床头柜在阴影里,露出的部分小,轮廓最难对齐。
系统是怎么跑起来的
模型负责什么
只返回一个完整的 Blender Python 脚本:房间外壳、窗、门、床、被子、枕头、床头柜、小物件、灯光和材质,全部程序化生成,不用外部模型和贴图。每个测得的物体按“编号_类别_部件”命名,并标注类别、能否移动和质量。模型不执行任何命令,也不碰相机和渲染设置。
驱动和评分负责什么
- 相机:按 H3 的内参(fx = 678.8,fy = 689.6)和第 0 帧的位姿摆放,Cycles 渲染。
- 评分:物体 IoU(对照 SAM 3 掩码);深度误差(对照 DA3 深度,尺度用机器人身高 1.75 m 校正,门高 1.98 m 交叉验证);悬空检查;PyBullet 1 秒静置测试(凸包碰撞体,被子这类软物体除外)。
- 反馈:参考帧、物体编号图、测量表、上一轮脚本,加上报错信息,或者对比图、房间内视角、俯视图和指标。
借鉴的开源项目:OpenAI 没有开源这一整套流程,只有博客演示。循环结构参考了 Codex-and-Blender(模型写 bpy、渲染、看图再改);修改的先后顺序参考了 SEIG 的分阶段逆向图形:布局 → 比例 → 物理 → 材质 → 灯光。LL3M(单个资产的多智能体建模)留给以后重建单个资产;blender-mcp 需要让模型实时操控 Blender,没有采用。
10 轮是怎么一步步改出来的
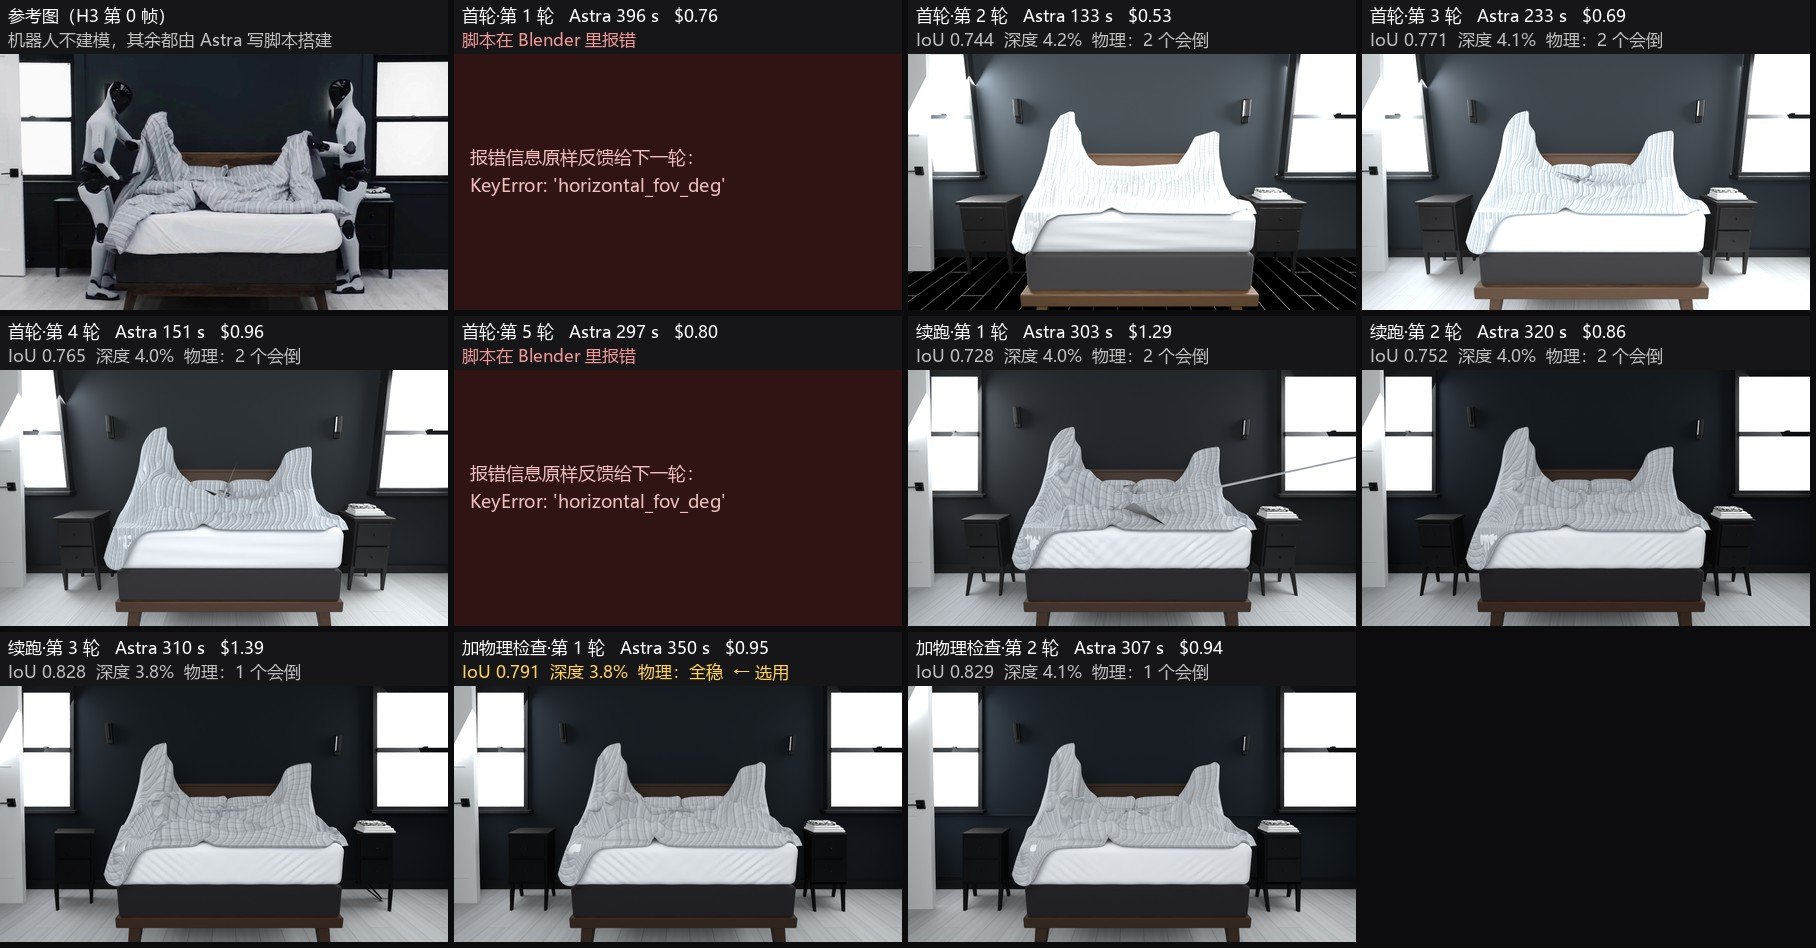
| 轮次 | IoU | 深度误差 | 物理静置测试 |
|---|---|---|---|
| 首轮·1 | — | — | 脚本报错 |
| 首轮·2 | 0.744 | 4.2% | 2 个枕头会掉 |
| 首轮·3 | 0.771 | 4.1% | 2 个枕头会掉 |
| 首轮·4 | 0.765 | 4.0% | 2 个枕头会掉 |
| 首轮·5 | — | — | 脚本报错 |
| 续跑·1 | 0.728 | 4.0% | 2 个枕头会掉 |
| 续跑·2 | 0.752 | 4.0% | 2 个枕头会掉 |
| 续跑·3 | 0.828 | 3.8% | 右床头柜倾倒 81° |
| 加物理检查·1 ✓ | 0.791 | 3.8% | 全部稳定 |
| 加物理检查·2 | 0.829 | 4.1% | 一个枕头翻倒 136° |
物理一列是事后用同一套静置测试统一重算的;前 8 轮 Astra 看不到这项反馈。早期几轮的枕头压在被子上,而被子作为软物体不参与仿真,所以枕头会往下掉。最终选用“加物理检查·1”:IoU 不是最高,但所有能自由摆放的物体都站得住。选优规则是 IoU − 深度误差 − 0.05 ×(会倒或悬空的物体数)。两次报错都源于测量表不一致:给 Astra 看的表里有视场角,传进 Blender 的表里没有,已修复。
物理检查抓到了图像看不出的问题
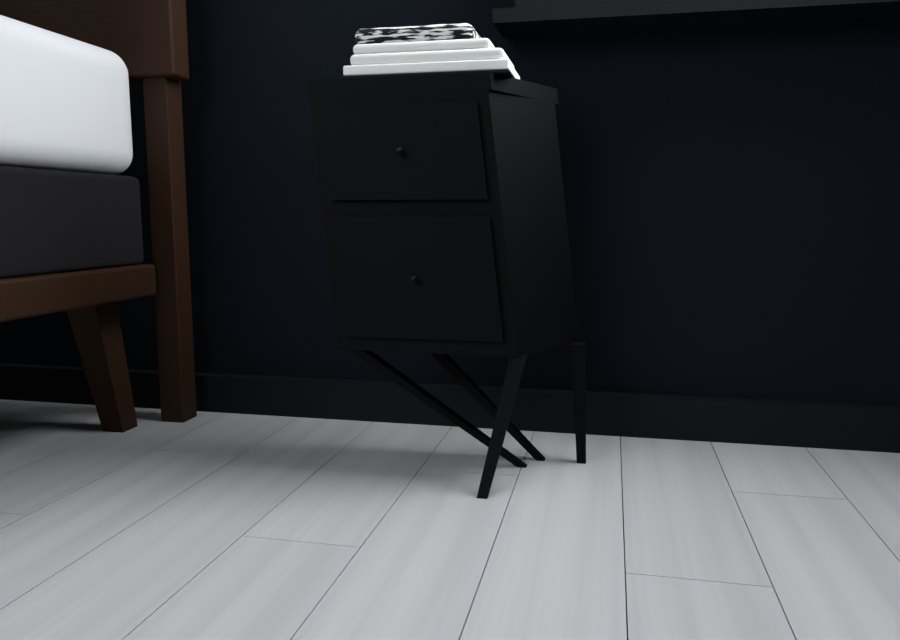
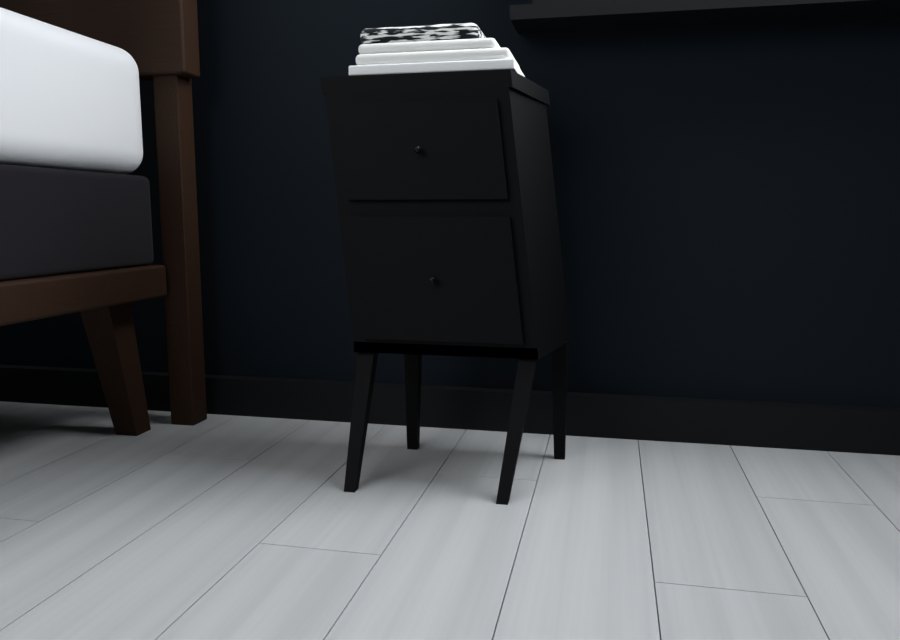
这两张是用 Blender 从床头柜右前方低处拍的特写。从参考视角看,这里只是床边一小块阴影,IoU 和深度误差都发现不了,静置测试却一放就倒。收到“右床头柜 1 秒内移动 58%、倾斜 81°”的反馈后,Astra 改写了床头柜的腿,还在脚本里留了注释:
# The two front feet share a floor depth and span the full cabinet,
# rather than converging beneath its right-hand side.
foot_pixels = (left_foot_px, right_foot_px)
top_pixels = (x0+8, x1-8)
for side in range(2):
    top = from_image(top_pixels[side], bottom_py, fy)
    top.y = fy+0.028
    top.z = bottom_z+0.002
    foot = floor_from_image(foot_pixels[side], foot_py)
    leg(f"front_leg_{side}", tuple(foot), tuple(top),
        0.021, 0.032, night_wood, "nightstand", iid, 0.45)
    back_top = Vector((top.x+rear_shift, fy+depth-0.028, top.z))
    outward = -0.004 if side == 0 else 0.004
    back_bottom = Vector((back_top.x+outward, fy+depth-0.018, 0.0))
    leg(f"rear_leg_{side}", tuple(back_bottom), tuple(back_top),
        0.022, 0.032, night_wood, "nightstand", iid, 0.45)
注释意思是:“两条前腿落在同一深度,横跨整个柜体,而不是收拢到右侧下方。”整个脚本约 1300 行,都是 Astra 写的。
换个角度看这个场景
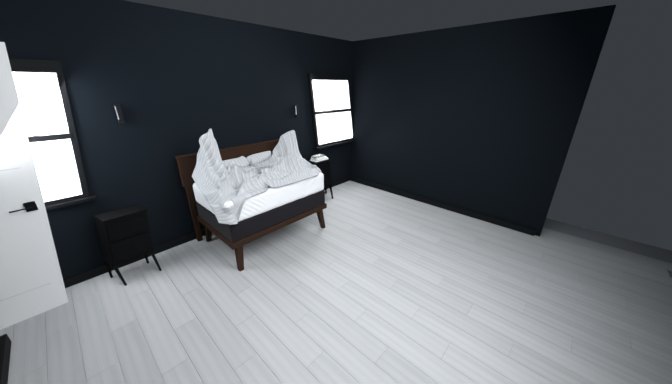
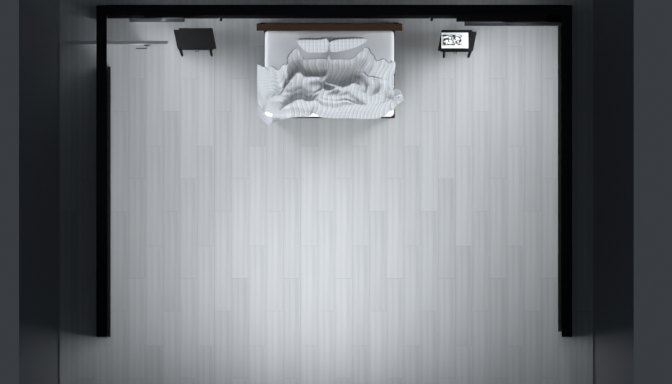
把场景当证据喂给 H3
做法沿用主页的资产证据:从第 68 帧起,每一段都把 Blender 在当前相机下渲染的画面用 H3 的 VAE 编码,作为干净的 K/V 追加进注意力。用种子 42 的换朝向回访轨迹,试了三种证据范围:
| 组别 | 证据覆盖 | 第二次访问(帧 198) | 机器人 |
|---|---|---|---|
| 基线 | 无 | 和第一次访问一致:按提示词画出的门和植物 | 在 |
| 完整场景 | 墙、地板、全部家具(约 100% 画面) | 照着 Blender 场景画成深色墙,第一次访问出现过的门和植物被抹掉 | 第 68 帧后消失 |
| 只用家具 | 不含墙和地板(约 50%) | 家具一致;空墙处画出圆镜、植物、长凳 | 消失 |
| 静态结构 | 不含被子和枕头,避开机器人区域(约 60–68%) | 墙面一致;机器人区域画出一盆植物 | 消失 |
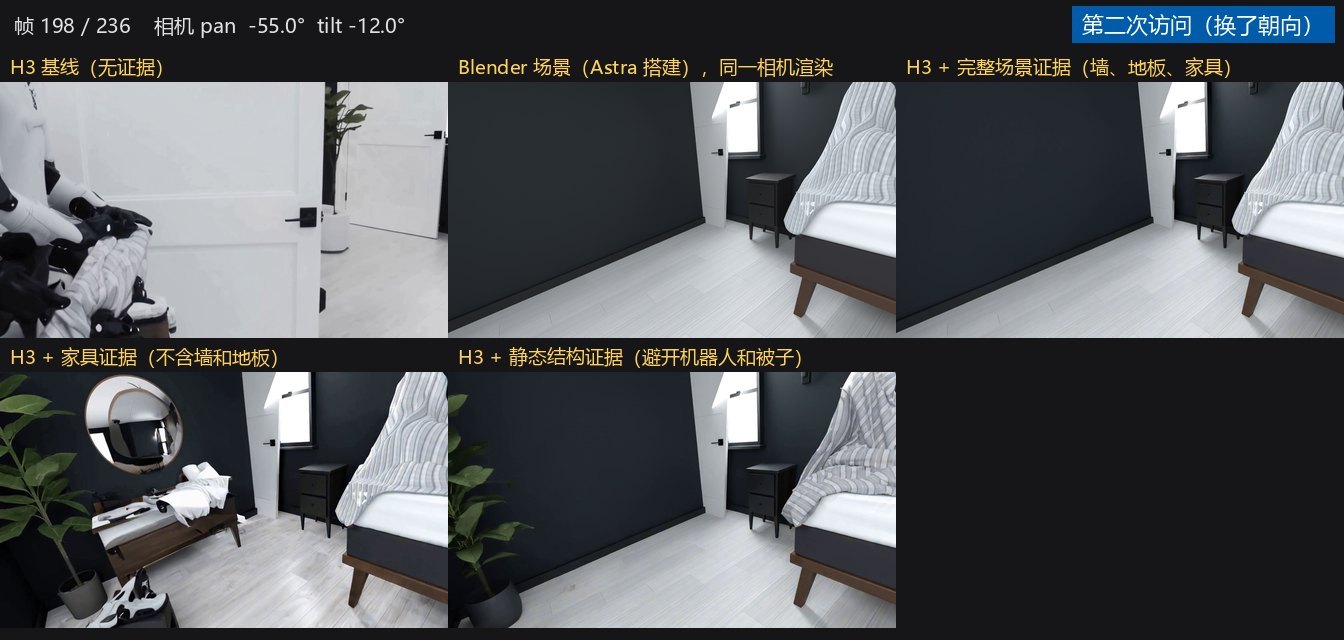
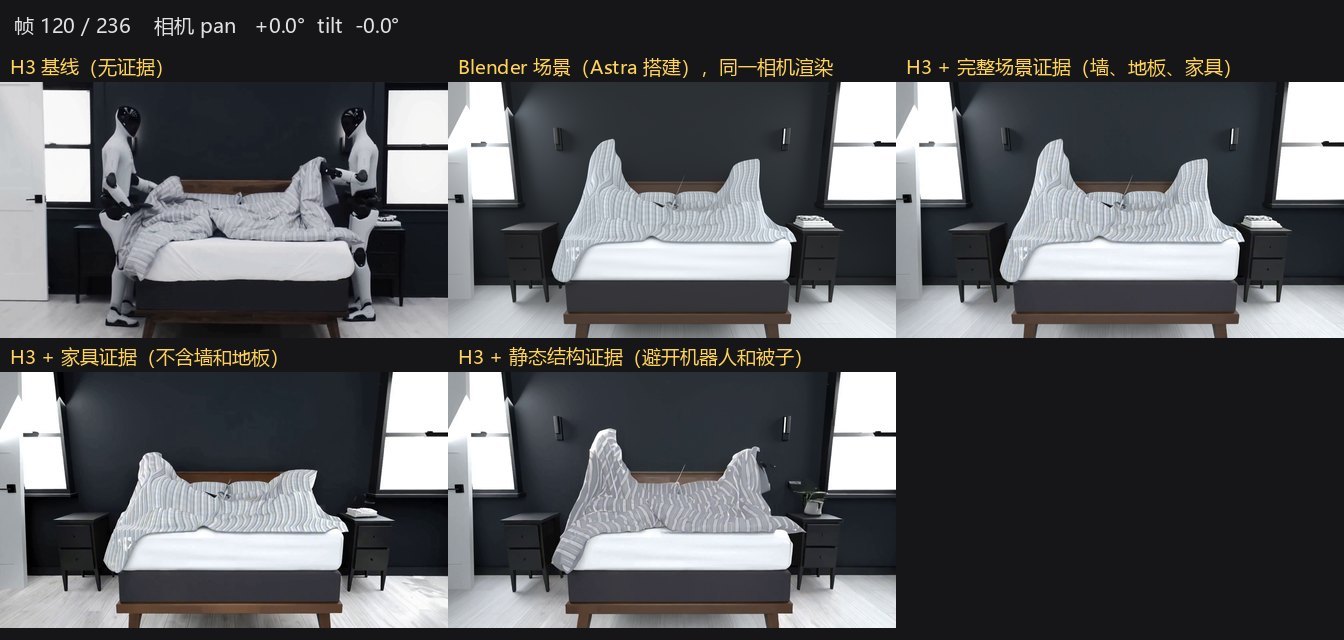
主页的实验里,资产证据只覆盖几个小物体,机器人保留了下来;这次证据覆盖了画面的一半以上,H3 就整体切换成照着静态场景渲染。即使把机器人区域排除在证据外,机器人也没有回来,空出的区域被填上了别的东西。所以要把这样的完整场景当证据,必须先控制证据强度。
更正(2026-10-07 晚):本页最初写的是“基线凭空多画了一扇门和一盆植物,证据让回访一致”。复查 H3 的提示词后发现,提示词里写了“圆镜、木书桌和笔记本电脑、角落里的高大绿植、白色镶板门”,这些内容在第一次访问(第 54 帧)就已经出现,基线前后两次访问其实是一致的。Blender 场景只根据第 0 帧搭建,没有这些东西,所以用它当证据时,第二次访问反而和 H3 自己的第一次访问对不上。正确的做法是先把第一次访问新看到的内容补进场景(慢速环的工作,也可以让 Astra 参照第 54 帧补建),再给第二次访问当证据。
局限与下一步
- 场景要跟上视频。第一次访问新看到的内容(门、植物等)要先补进三维场景,再给回访当证据,否则证据会和视频自己的第一次访问冲突。
- 控制证据强度。只在回访的片段注入、只在前几层注入、给证据加噪声(不用完全干净的证据)、限制证据 token 的占比。目标是房间保持一致,同时机器人保留。
- 接入慢速环。用 Astra 搭的场景作为世界的初始资产,H3 新生成的物体再按准入规则加入。
- 重建被拒的资产。主页实验里 53 个候选物体只通过 5 个,主要卡在单视角网格过不了物理检查。可以用同样的“写脚本 → 渲染 → 对照”循环重建,物理检查直接复用。
- 泛化。目前只搭了一个场景、只试了一条纯旋转轨迹;这个场景约 10 轮、$9。还需要在更多参考图上统计平均要几轮、花多少钱。