能改吗?能动吗?把 Blender 场景用于视频编辑,并尝试把动态内容也建模
在 GPT-6 Astra 搭好的房间上做了三种编辑、一次“改首帧再让 H3 重新生成”的视频编辑,以及动态内容的逐帧三维抬升
结论速览
- 能改,而且改起来很便宜。场景是一个带名字、带标签的 Blender 工程:材质、位置、朝向都能按参数直接改,几秒完成,渲染一张约 10 秒。更复杂的改动(换一种家具、加一盏台灯)可以用一句话让 Astra 改它自己写的脚本。改完自动重新导出、做物理检查,任意视角重新渲染都同步变化。
- “改首帧,再让 H3 重新生成”已经能做材质和风格类的视频编辑。把编辑后的场景从第 0 帧的相机渲染出来,贴回原图里的机器人,作为 H3 的新输入:绿被子、浅色墙、深色地板贯穿整段视频,机器人照样在铺床,镜头左转时新露出的区域也按新风格生成。代价是动作是重新生成的:前半段和原视频相近,后半段机器人的位置就不同了。
- 改几何(挪床、转床头柜)不能直接这么做。机器人正在和床交互,床一挪,机器人的动作就对不上。这类编辑要么把动态内容也建模,要么让 H3 重新生成动作。
- 动态内容目前能做到“逐帧 2.5D 抬升”。每帧深度用静态场景的地板定尺度,机器人和被子放进同一个米制坐标系,从新视角能看到它们相对床的位置。但抬升出来的只是朝向相机的那一面,像纸板,不能换姿势、换外观。真正建模要把机器人关节化(姿态估计 + 骨骼绑定),被子要做布料跟踪或仿真。
- 更正:之前说“Blender 证据让回访一致”不准确。H3 的提示词里写了门、绿植、书桌和圆镜,第一次访问时就已画出;只根据第 0 帧搭的场景没有它们,当证据时反而把它们抹掉了。详见 Blender 场景页的更正。
改材质、改位置朝向、一句话换家具
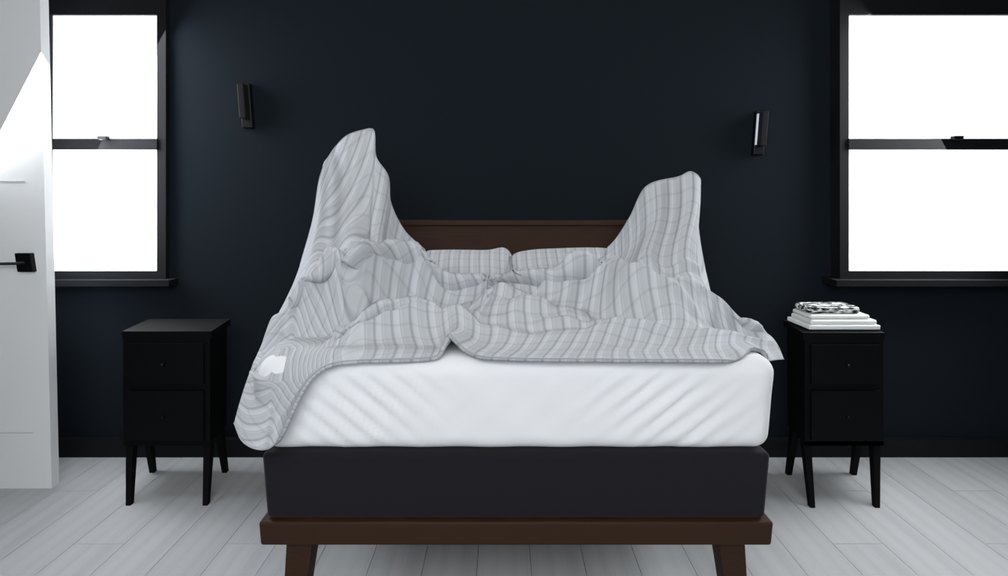
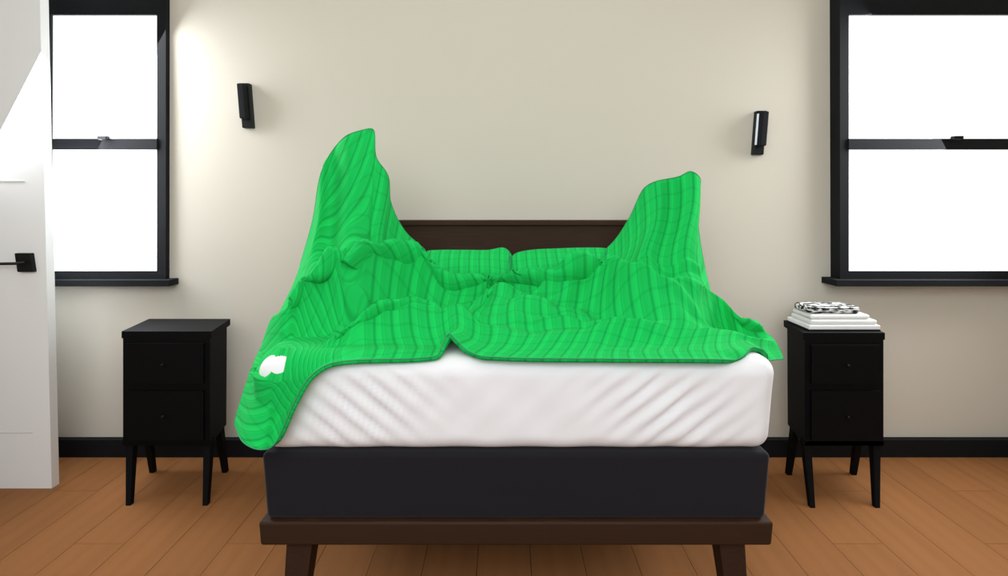
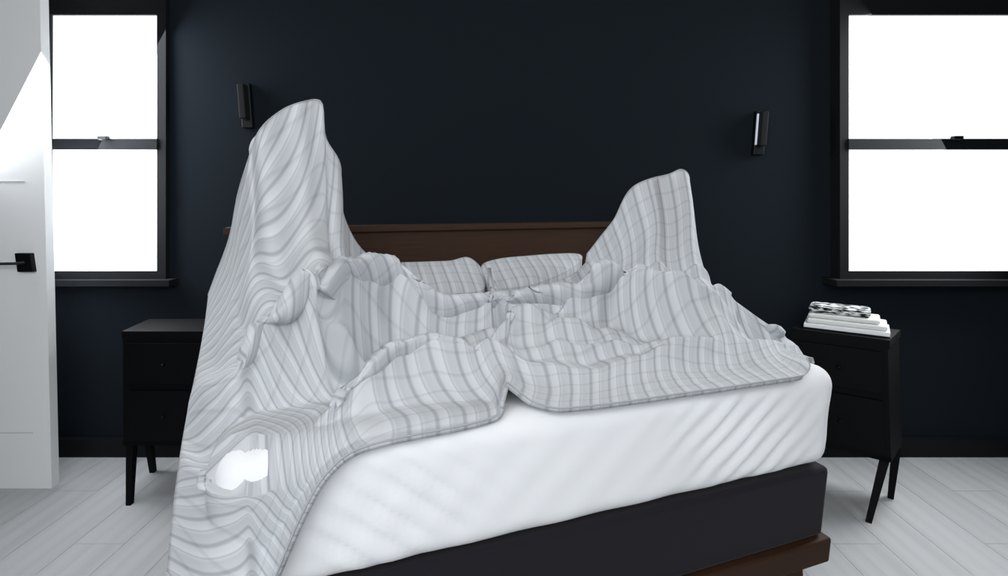
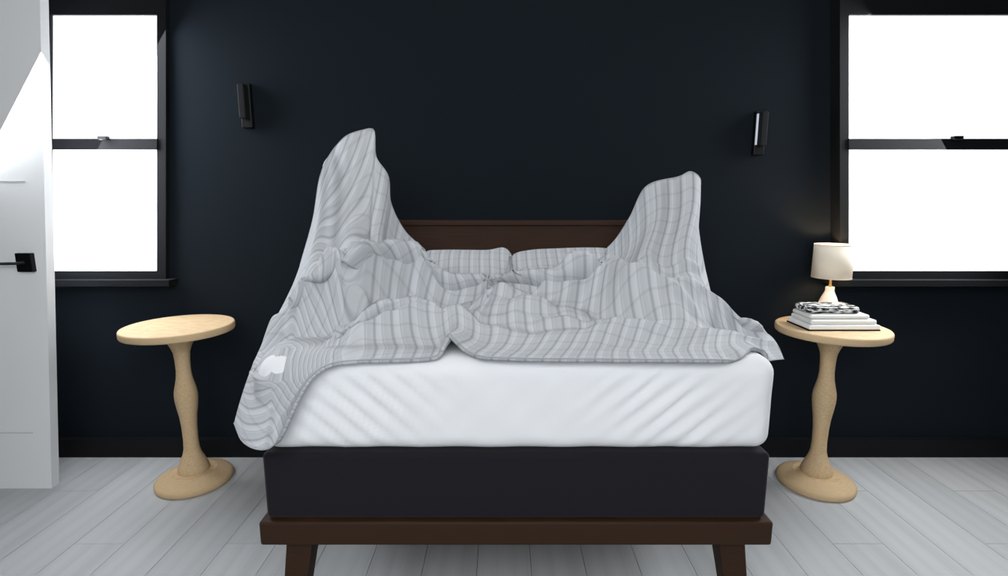
| 编辑 | 怎么改 | 用时 | 编辑后物理检查 |
|---|---|---|---|
| A 改材质 | 参数化:按亮度把材质节点里的颜色映射到新色调,程序化条纹和木纹保留;墙和天花板直接换成纯色材质 | 几秒,渲染约 10 秒 | 全部稳定 |
| B 改位置和朝向 | 参数化:按实例编号整体平移、绕竖直轴旋转;放在床头柜上的书和毛巾按名字一起带走 | 几秒 | 全部稳定(床位移 0.03%) |
| C 一句话换家具 | Astra 读当前脚本和三张渲染图,按指令改写脚本,驱动重新搭建、渲染、导出 | 232 秒,$0.84,一次成功 | 全部稳定 |
编辑 C 里 Astra 自己写的修改说明(摘译):“只替换两个柜子,改成 45 cm 的浅橡木独腿边桌,保留原来的中心位置、桌面高度和实例标签;书和毛巾留在原处,在右桌后侧的空位加一盏暖光陶瓷台灯;其余不动。”
编辑能“指哪改哪”,靠的是搭建时留下的结构:每个物体按“编号_类别_部件”命名,带类别、能否移动和质量。开门这类关节编辑还需要知道铰链在哪里,可以让 Astra 在搭建时给门加一个铰链空物体。
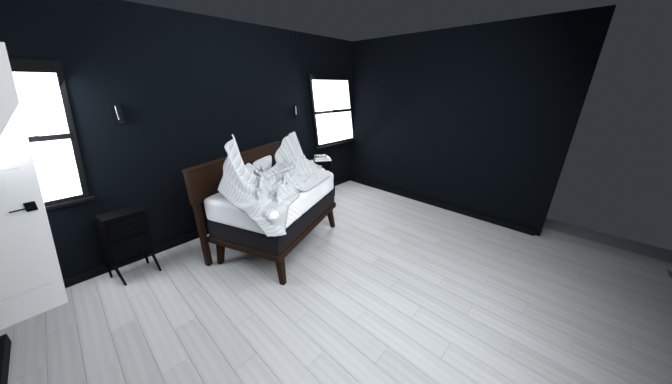
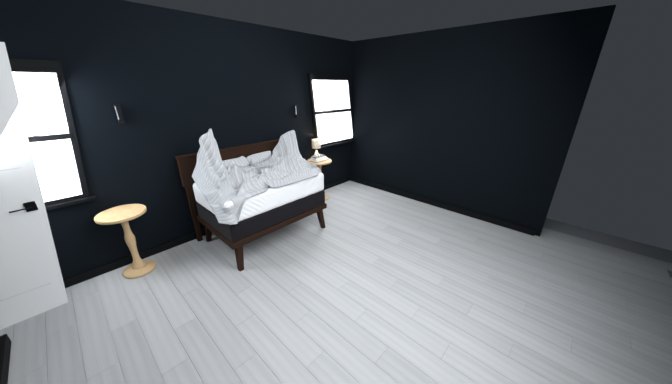
用来做视频编辑
实测:改首帧,再让 H3 重新生成
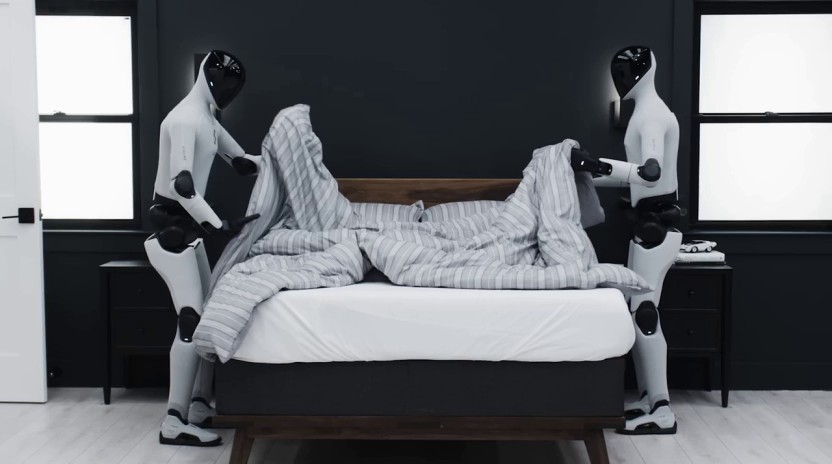
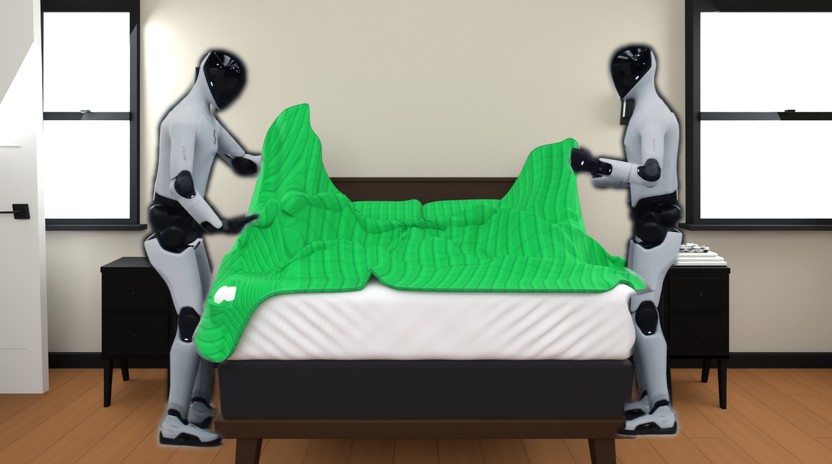
提示词同步改成“浅暖灰墙、深胡桃木地板、深绿色条纹被子”,其余不变;种子和相机轨迹与原视频相同,不注入任何证据。
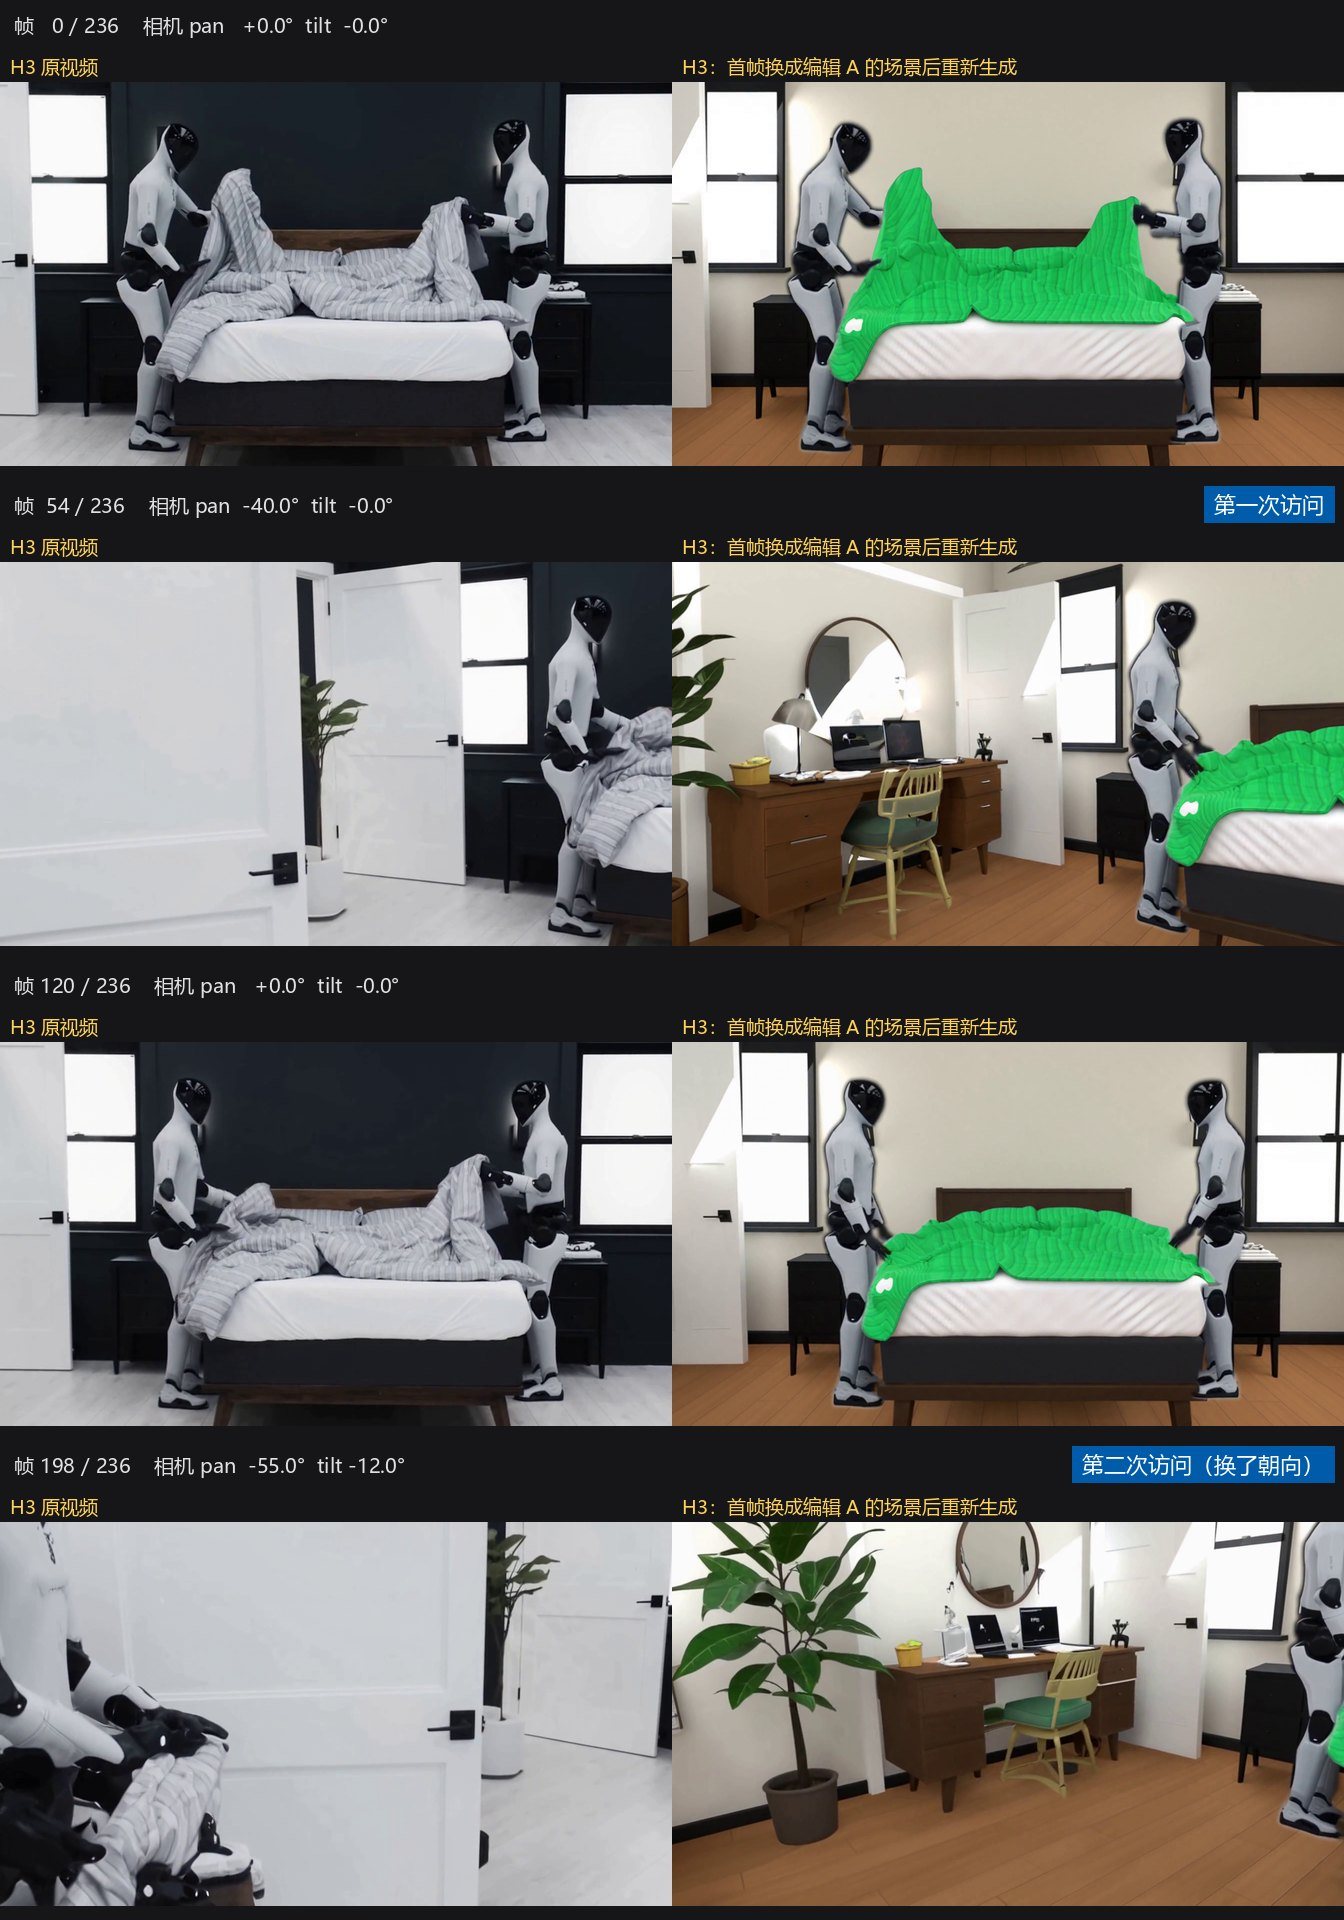
- 改动贯穿整段视频:被子一直是绿色,墙一直是浅色,地板一直是深色。
- 机器人保留:它们在输入图里,H3 接着生成它们铺床的动作。
- 新露出的区域按新风格生成:镜头左转时出现了木书桌、笔记本电脑、绿椅子、圆镜和绿植。这些来自提示词,配色跟随编辑后的房间。
- 动作是重新生成的:前半段和原视频相近,后半段不同。比如第 198 帧,原视频里机器人贴在镜头左前方,编辑后的视频里机器人在画面右边缘。
- 首帧是 CG 渲染,画面整体偏 CG。
三条路线
| 路线 | 做法 | 现在能做吗 | 保留原动作 |
|---|---|---|---|
| 改首帧,重新生成 | 编辑场景 → 从第 0 帧相机渲染 → 贴回机器人 → H3 生成 | 能(本页实测) | 否,同种子下相近 |
| 编辑后的场景当证据 | 每一段都用编辑后场景的渲染当证据 | 部分 | 否 |
| 合成 | 每帧渲染编辑后的静态场景,把原视频的动态层(机器人、被子)按掩码和深度贴回 | 组件都有,还没拼起来 | 是,逐帧保留 |
动态内容能不能建模
先试最直接的办法:逐帧把机器人和被子抬升到场景的米制坐标系里。每一帧做四步:
- DA3 估计深度。
- 在同一相机下渲染静态场景的深度,用地板像素上的比值确定这一帧的尺度。
- SAM 3 抠出机器人和被子,按尺度后的深度反投影到三维。
- 从一个新视角(右前方 1.7 m 高处)把这些点画进 Blender 静态场景。背景渲染时去掉了被子和枕头,因为视频里它们一直在被机器人搬动。
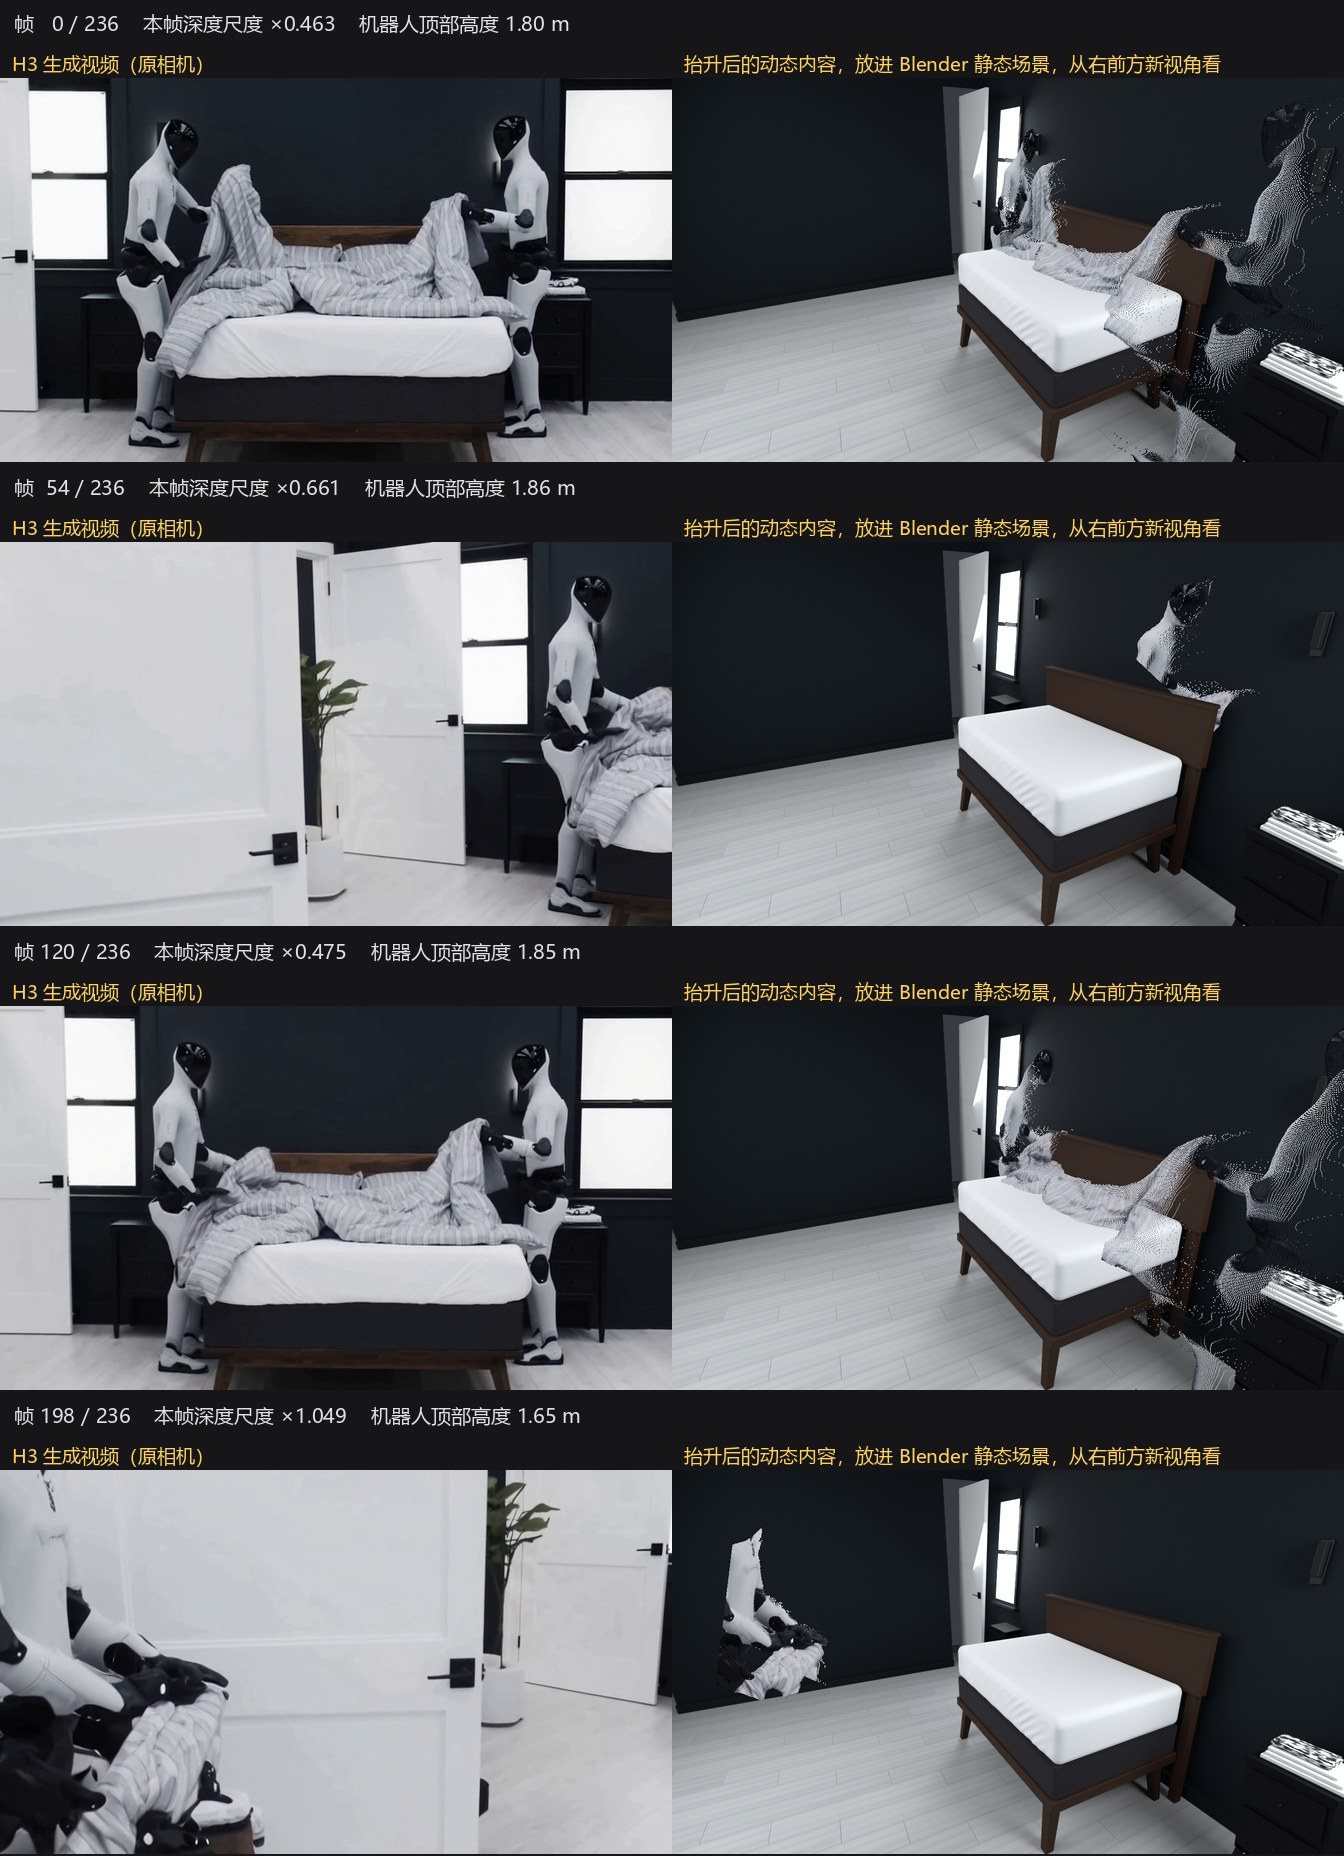
逐帧尺度:必须逐帧定标,用地板比用整幅场景稳
DA3 每帧自己估的尺度会漂:正面约 0.46,左转时约 0.65,第二次访问时约 1.1,所以必须逐帧定标。用整幅静态场景定标时,镜头左转后会出错:H3 在那里按提示词画了门外的另一个房间,场景里却是一堵墙。只用地板定标更稳。
机器人顶部高度(98% 分位)。正面视角两种定标都稳定在 1.80 m(绿色虚线);第一次访问时,整幅场景定标把机器人估高到 1.93 m,只用地板定标是 1.86 m。第二次访问时机器人被画面边缘截掉一部分,这一段的高度只能作参考。
要真正建模动态内容,分四级
| 级别 | 得到什么 | 怎么做 |
|---|---|---|
| 0 · 逐帧 2.5D 抬升(本页) | 每帧一层带颜色的表面点,米制、和场景对齐 | 深度 + 掩码 + 已知相机,用场景地板定标 |
| 1 · 关节化机器人 | 每个机器人一套带骨骼的完整网格,每帧一个姿态;能从任意视角重渲染、换外观、改动作 | 逐帧估计人形姿态(机器人是人形,可先试人体模型),绑定到 Astra 搭的机器人模型上 |
| 2 · 可形变的被子 | 每帧一张被子网格 | 以 Astra 的被子网格为模板,按每帧深度和掩码做非刚性跟踪;或用 Blender 布料仿真,由机器人手的轨迹驱动 |
| 3 · 通用四维表示 | 能从新视角回放的动态场景,但不能按物体编辑 | 4D 高斯、多视角视频扩散 |
级别 1 做成后能一举两得。第一,证据里有了机器人,H3 在完整场景证据下就不会再把机器人抹掉,因为它会照着证据画,连机器人一起画。第二,视频编辑可以保留原动作:改场景,按原动作重渲染 CG 代理,再让 H3 把代理“画”成真实画面。这和 UniMoCa(2608.01944)用三维代理视频控制生成、Wan-Animate(2509.14055)替换角色而保留动作是同一个方向;区别是这里用不训练的证据注入,代替它们训练出来的控制分支。
建议的下一步
- 场景同步:第一次访问后,把新看到的内容(门、绿植、书桌)补进场景,可以让 Astra 参照第 54 帧补建,也可以由慢速环抬升;之后再给回访当证据。
- 证据强度控制:减少注入层数、只在回访片段注入、给证据加噪声、限制证据 token 占比。
- 视频编辑先走两条已经可行的路:材质和风格类编辑用“改首帧再生成”;需要保留原动作的静态编辑用合成路线。
- 机器人关节化(级别 1):先在节点上装 Human3R,测它对人形机器人的姿态估计效果。