白膜能当条件吗?training-free 白膜控制实验
把 Blender 里重建的无纹理几何(白膜)沿相机轨迹渲染,交给五类视频模型,看它能不能像 World in World 那样控制生成,而且不需要训练
结论速览
- 可以,但要分模型看。原版 MiniMax-H3 自带的 ref2va 就能把白膜当条件:白膜视频作为「编辑源」、照片作为「编辑后的首帧」,几何和相机跟白膜,外观跟照片,墙面是照片里的深炭灰,没有照抄白膜的灰色。三个随机种子的整体重合度 0.46 / 0.52 / 0.69,第一次左转都在 0.78 以上。
- H3 的条件是一整套配合,缺一项就失败。要用官方六段式提示词(
[video editing + keyframe completion]),镜头描述要带逐段时间戳并和白膜视频一致,参考视频要补到和生成一样的 243 帧。去掉时间戳整体只有 0.171,不补帧 0.164;只有文字镜头描述(fl2va)也只有 0.143。 - 反直觉:参考视频越像照片,H3 越不跟相机。同样的设置下,换成彩色渲染、照片投影上色、按物体上色的白膜,第一次左转都停在床上(0.03–0.04)。纯白膜和照片外观差得远,模型才把它当成结构和相机来源。
- K/V 证据注入会把白膜当外观照抄。LingBot(经 World in World)和 SolarWM-H3 都是把证据画面的注意力 K/V 拼进生成过程;白膜进去,空洞或整个画面就变成灰色石膏(SolarWM 灰像素占比 1.00,LingBot 空洞和白膜的 PSNR 23–31 dB)。只在第 1 步注入、半权重、把 V 的统计量对齐到首帧,都分不开几何和外观。
- 解法:白膜先自动上色,只拿来补空洞。每个物体取它在照片里的中位色,乘上白膜的明暗,不用任何手写材质;照片看得见的地方仍用 WiW 从源视频投影的画面,看不见的空洞用上色白膜。这样几何跟白膜、墙是真实颜色、机器人保留并照常运动,3 个种子、平移相机都成立。
- 训练过的控制分支(我们不用训练)几何最强。H3 Fun-ControlNet 用白膜线稿控制,重合度 0.835–0.839(两个种子),平移相机 0.850;再把照片接成首帧,重合度 0.872(平移 0.885)、首帧 PSNR 约 29.7 dB,几何和照片外观都有了。Wan2.1-VACE 用白膜深度控制,生成画面的深度和白膜的相关系数 0.95(白膜本身 0.966),但照片只能迁移配色。
- 白膜可以直接用来做视频编辑。在 Blender 里改材质、渲染首帧并贴回机器人,配原来的白膜视频,原版 H3 把浅色墙、绿色被子、木地板一路带到镜头转到的新区域。
- 换到彩色客厅也成立,但 H3 的镜头跟随有随机性。H3 照片 + 白膜在第二个场景同样没有照抄灰色(色彩度 33–36),4 个种子的物体对齐 0.29–0.56;Fun-ControlNet 照片首帧 + 白膜线稿 0.623,接近 Astra 渲染自己的 0.704。
- 局限:主要结论来自一个卧室场景和一条主轨迹,第二个场景只跑了原版 H3(4 个种子)和 Fun-ControlNet(3 组);平移相机下 H3 第一次左转的跟随更不稳定;证据铺满全画面时(SolarWM)机器人会在第 68 帧后消失。
一、白膜怎么渲染
场景用 GPT-6 Astra 在 Blender 里按照片重建,相机标定为 60° 视场角(见深度与相机页),沿 H3 的「换朝向回访」轨迹渲染 237 帧:先左转 40° 停住,回正;再左转 55° 并下俯 12°,停住,回正。
- 白膜:所有表面换成同一种浅灰漫反射,场景灯光不变。灯光是按深色墙调的,白膜会过曝,所以先低分辨率试渲三帧,自动把曝光压到 −2.83 EV。
- 深度 / 法向:用只发光的材质直接写数值;深度存 16 位逆深度(近亮远暗),法向是相机坐标系。
- 照片投影上色:每帧用白膜深度把像素反投到参考相机,做深度遮挡测试,看得见的地方取照片颜色,看不见的保留白膜;两个机器人所在的像素不取色。平均 51% 的像素拿到照片颜色,转得最远时只剩 6%。
- 均色白膜(自动上色):渲染物体 ID,每个物体取它在照片里可见像素的中位色(墙、地板这类被拆成很多块的面按组取色),乘上白膜的明暗。不使用任何材质。
二、原版 MiniMax-H3:用自带的 ref2va
ref2va 的视频参考不是 ControlNet 那种逐帧对齐的控制,而是在时间轴上拼在目标前面的上下文:Qwen3-VL 以 2 fps 读它(语义),视频 VAE 把每一帧编码成固定的锚点(像素)。保留什么、改什么完全由提示词决定,官方格式是六段式,任务前缀、保留标记和每个标签的角色都有固定写法。
「重合度」:在生成画面里用 SAM 3 分割床、床头柜、窗、门、床头板,与 3D 场景按同一相机投影的物体比 IoU,取 17 个采样帧平均;「第一次左转」看第 44、56 帧,「第二次左转」看第 180、196 帧。首帧 PSNR 和原始照片比较;机器人比例是检测到机器人的采样帧占比。
| 组 | 参考图 | 参考视频 | 提示词 | 整体 | 第一次左转 | 第二次左转 | 首帧 PSNR | 有机器人 |
|---|---|---|---|---|---|---|---|---|
| C | fl2va:照片作首帧,镜头只用文字描述 | 0.143 | 0.05 | 0.00 | 35.1 | 100% | ||
| A | 照片 | 彩色渲染 | 第一批 | 0.174 | 0.03 | 0.59 | 18.9 | 77% |
| B | — | 彩色渲染 | 第一批 | 0.361 | 0.06 | 0.84 | 13.6 | 83% |
| WA | 照片 | 白膜 | 第一批 | 0.207 | 0.03 | 0.58 | 16.4 | 80% |
| WB | — | 白膜 | 第一批 | 0.188 | 0.13 | 0.11 | 10.5 | 87% |
| WC | 照片 | 深度 | 第一批 | 0.166 | 0.02 | 0.01 | 17.2 | 100% |
| WD | 照片 | 照片投影上色 | 第一批 | 0.208 | 0.03 | 0.65 | 20.5 | 83% |
| R3a | 照片 | 白膜 | 官方格式 | 0.461 | 0.83 | 0.38 | 18.0 | 80% |
| R3a 种子 7 | 照片 | 白膜 | 官方格式 | 0.522 | 0.80 | 0.38 | 18.8 | 77% |
| R3a 种子 123 | 照片 | 白膜 | 官方格式 | 0.694 | 0.78 | 0.66 | 18.7 | 80% |
| R3b | — | 白膜 | 官方格式 | 0.501 | 0.71 | 0.39 | 11.8 | 83% |
| R3b 种子 7 | — | 白膜 | 官方格式 | 0.153 | 0.05 | 0.47 | 13.8 | 80% |
| R3b 种子 123 | — | 白膜 | 官方格式 | 0.430 | 0.92 | 0.14 | — | — |
| R3c | 照片 | 深度 | 官方格式 | 0.329 | 0.71 | 0.37 | 19.0 | 80% |
| R3a2 | 照片 | 彩色渲染 | 官方格式 | 0.190 | 0.03 | 0.67 | 20.4 | 80% |
| R3p | 照片 | 照片投影上色 | 官方格式 | 0.182 | 0.03 | 0.63 | 20.7 | 80% |
| R3m | 照片 | 均色白膜 | 官方格式 | 0.155 | 0.04 | 0.38 | 19.6 | 80% |
| R3d | fl2va:照片作首帧 + 彩色渲染第 208 帧作尾帧 | 0.211 | 0.32 | 0.44 | 31.0 | 81% | ||
| R3a 去掉时间戳 | 照片 | 白膜 | 镜头只写「跟随视频」 | 0.171 | 0.02 | 0.08 | 18.4 | 87% |
| R3a 不补帧 | 照片 | 白膜(237 帧,被截成 226) | 官方格式 | 0.164 | 0.22 | 0.33 | 17.3 | 80% |
- 第一批全部卡在第一次左转:旧格式下,带照片的组(A、WA、WC)整体只有 0.17–0.21,第 44–64 帧还停在床上。官方格式 + 用 1344×768 的照片 + 参考补帧之后,照片 + 白膜(R3a)第一次左转到 0.83,三个种子都在 0.78 以上。
- 只给白膜(R3b)不稳定:3 个种子 0.501 / 0.153 / 0.430,有的第一次左转失败,有的第二次左转失败。照片给了模型一个稳定的起点。
- 第二次左转(55°)大家都到了,但彩色、投影参考停得更准(0.59–0.84),白膜约 0.38:门的位置和大小有偏差。
- 深度视频(R3c)也能当结构参考,但比白膜弱,第一批格式下(WC)还多画了一扇门。
平移相机:有视差时还跟得住吗
同样的配方换成「平移回访」轨迹:第二段动作时相机一边左转 50°,一边向左平移 0.66 m、向前 0.22 m,靠近门口。白膜按米制轨迹重新渲染,提示词里的第二段镜头改成平移描述。
| 组 | 整体 | 第一次左转(同旋转轨迹) | 平移后的停留段 | 首帧 PSNR | 有机器人 |
|---|---|---|---|---|---|
| 照片 + 白膜 | 0.245 | 0.45 | 0.51 | 17.8 | 87% |
| 照片 + 均色白膜 | 0.230 | 0.22 | 0.60 | 19.4 | 87% |
| 只给白膜 | 0.415 | 0.48 | 0.55 | 12.0 | 80% |
平移后的视角跟到了(0.51–0.60),但这一次第一次左转只跟了一半(旋转轨迹上是 0.78–0.83),说明 H3 跟随视频参考的相机本身有随机性。
用白膜做视频编辑
首帧换成之前在 Blender 里改过材质的版本(浅暖灰墙、绿色条纹被子、蜂蜜色木地板,机器人从原图贴回),参考视频仍是原来的白膜,提示词把材质描述换掉。结果首帧和编辑图一致(SSIM 0.83),第一次左转 0.80,转到的新区域也是编辑后的风格。也就是说,只要改一张首帧,几何和镜头由白膜保证,H3 会把编辑传播到整段视频。
三、LingBot-World 2.0 + World in World:K/V 证据注入
World in World(WiW)的做法是:把证据画面(源视频按深度投影到目标相机的画面)在 t=0 过一遍冻结的 LingBot,取出每层注意力的 K/V,在前 3 个去噪步里拼进当前段的注意力,按可见度给 logit 加权。源视频看不到的区域是「空洞」,不给证据,由模型自己生成。我们沿用它的实现,只替换证据画面;相机内参改成标定的 60°(WiW 默认按 90° 处理这段视频)。
指标都在空洞区域里算(第 44 帧和第 196 帧镜头转开后露出来的墙、门、地板),取 3 个随机种子的均值:和白膜比的 PSNR 越高越像照抄白膜;和彩色渲染比的 PSNR 越高说明跟着上色的网格走;边缘相关衡量空洞里的几何是否跟白膜一致。
| 空洞里放什么 | 与白膜 PSNR | 与彩色渲染 PSNR | 饱和度 | 与白膜边缘相关 | 观察 |
|---|---|---|---|---|---|
| 不放(WiW 原生) | 9.2 / 9.7 | 12.4 / 11.6 | 0.22 / 0.15 | 0.01 / −0.02 | 空洞里编出圆镜、书桌、绿植,每个种子编的都不一样 |
| 白膜 | 23.4 / 30.6 | 11.0 / 12.0 | 0.08 / 0.08 | 0.16 / 0.12 | 几何跟上了,墙和地板照抄成灰色,机器人边缘有白色描边 |
| 彩色网格(Astra 材质) | 10.8 / 11.5 | 24.2 / 30.6 | 0.27 / 0.23 | 0.20 / 0.22 | 几何跟随,深炭灰墙,机器人保留 |
| 均色白膜(自动上色) | 9.7 / 10.9 | 21.9 / 22.7 | 0.31 / 0.26 | 0.28 / 0.23 | 和彩色网格几乎一样,闪烁最低;不需要任何材质 |
只跑了种子 42 的其他做法:白膜权重降到 0.25 时几何控制丢了,在白膜没有门的地方多编了一扇门;V 统计量对齐首帧后颜色偏紫蓝灰、地板长出砖纹;只在第 1 步注入时墙上多出开关面板和竖缝;整段画面都用白膜、彩色渲染或均色白膜当证据(不用源视频投影),会几乎逐帧照抄渲染,机器人消失。
平移相机
相机向左平移时,第 180–196 帧约 99% 的画面都是源视频没见过的空洞。先用 WiW 的深度和白膜的米制深度算出单位换算(0.136 m / WiW 单位,近处和远处并不完全一致),再统一相机运动。3 个种子平均:空洞补均色白膜时,空洞和均色白膜的 PSNR 31.8 / 34.1 dB、与白膜边缘相关 0.52 / 0.55、停留段闪烁 0.20;原生只有 10.3 / 9.9 dB、相关约 0,闪烁 0.65。
四、SolarWM-H3:我们的证据注入
SolarWM-H3 用和 WiW 同类的接口:证据画面在干净时刻过一遍冻结模型,取资产覆盖到的 token 的 K/V,从第 4 段(第 68 帧)起拼进注意力。种子 42,换朝向回访轨迹。
| 证据 | 整体重合度 | 第二次左转 | 色彩度 | 灰像素占比 | 有机器人 |
|---|---|---|---|---|---|
| 无(基线) | 0.461 | 0.09 | 6.6 | 0.63 | 97% |
| 彩色网格 | 0.764 | 0.72 | 9.4 | 0.41 | 30% |
| 白膜(全程注入) | 0.663 | 0.48 | 2.1 | 1.00 | 30% |
| 白膜,只在第 1 步注入 | 0.457 | 0.06 | 3.4 | 0.98 | 63% |
| 白膜,只在前 2 步注入 | 0.413 | 0.21 | 2.2 | 0.99 | 30% |
| 白膜,V 统计对齐首帧 | 0.707 | 0.69 | 3.8 | 0.87 | 30% |
| 白膜,半权重混合 | 0.506 | 0.06 | 4.3 | 0.83 | 63% |
| 白膜,只给家具 | 0.478 | 0.04 | 5.9 | 0.78 | 37% |
| 彩色网格,只在第 1 步注入 | 0.561 | 0.42 | 6.9 | 0.40 | 70% |
| 照片投影(只用看得见的像素) | 0.604 | 0.06 | 7.6 | 0.60 | 67% |
| 照片投影 + 白膜 | 0.559 | 0.15 | 6.0 | 0.72 | 30% |
| 均色白膜(自动上色) | 0.624 | 0.69 | 7.6 | 0.41 | 30% |
- 规律和 LingBot 一致:白膜进去几何能跟(0.663),但画面全灰;只在第 1 步注入,几何控制没了,灰色还在(低频的颜色恰好在最早几步定型);上色的网格最好,均色白膜颜色正常、第二次左转 0.69。
- 这里的证据是静态场景、铺满全画面,机器人在第 68 帧后消失(只剩 30%)。证据较弱或带空洞的组能保住 63–70%。LingBot 那种「源视频投影 + 白膜补空洞」的组合避开了这个问题。
五、现成的控制模型(训练好的,我们不用训练)
H3 Fun-ControlNet-Union 2.0
阿里 PAI 为 H3 训练的控制分支(10 层注入,支持深度、Canny、MLSD 等)。控制视频由白膜生成:深度用逆深度可视化,线稿 = 法向图的折线 + 深度图的遮挡边。官方管线只支持 t2va(外观全靠文字);「照片首帧」是我们参照 ComfyUI 的做法,给首帧条件行补零控制行接上的。
| 控制 | 整体重合度 | 第一次左转 | 第二次左转 | 首帧 PSNR | 有机器人 |
|---|---|---|---|---|---|
| 白膜线稿 | 0.839 | 0.89 | 0.72 | 13.2 | 77% |
| 白膜深度 | 0.624 | 0.61 | 0.59 | 12.4 | 80% |
| 照片首帧 + 深度 | 0.669 | 0.87 | 0.21 | 28.8 | 83% |
| 深度,控制强度 0.6 | 0.290 | 0.03 | 0.24 | 7.3 | 83% |
| 照片首帧 + 白膜线稿 | 0.872 | 0.90 | 0.72 | 29.8 | 80% |
| 白膜线稿,种子 7 | 0.835 | 0.90 | 0.90 | 13.0 | 80% |
| 平移轨迹:白膜线稿 | 0.850 | 0.90 | 0.98 | 13.6 | 80% |
| 平移轨迹:照片首帧 + 白膜线稿 | 0.885 | 0.91 | 0.98 | 29.7 | 83% |
线稿比深度强:深度在大面墙上几乎没有结构,线稿把墙角、踢脚线、门框、地板缝都画了出来。平移轨迹上第二次转身后的停留段达到 0.98。照片首帧的接法是经验性的(控制分支训练时没见过首帧条件行),首帧加深度时第二次左转明显变差,首帧加线稿则没有这个问题。
Wan2.1-VACE
832×480、81 帧、50 步。「深度相关」是生成画面估出的视差和白膜深度的相关系数(白膜渲染本身 0.966,真实照片对白膜深度 0.906)。
| 设置 | 深度相关 | 首帧 PSNR / SSIM | 观察 |
|---|---|---|---|
| 深度 + 参考图 | 0.953 | 15.7 / 0.72 | 几何和镜头完全跟随;照片只迁移配色材质,细节由模型编 |
| 只有深度 | 0.958 | 12.7 / 0.57 | 外观完全由文字决定,和照片不符 |
| 深度 + 照片作首帧 | 0.939 | 33.7 / 0.97 | 首帧锁住、色调继承照片;照片里有、网格里没有的机器人在第 1–2 帧消失 |
| 白膜当灰度控制 | 0.957 | 10.0 / 0.46 | 亮度被锁死,输出就是上了色的白膜,不可用 |
六、怎么选
| 需求 | 推荐做法 | 注意 |
|---|---|---|
| 外观来自照片、几何和镜头来自白膜,离线生成 | 原版 H3 ref2va:照片作编辑后的首帧 + 纯白膜视频,官方六段式提示词,镜头逐段写时间,参考补到 243 帧 | 不要给彩色或投影参考;第一次转身偶尔跟不全,建议多种子挑选 |
| 交互式 / 长时序世界模型(LingBot、WiW) | 白膜按物体自动上色,只补源视频投影的空洞 | 不要把纯白膜当证据,也不要整段画面都用网格证据 |
| 几何控制最准,外观也要像照片 | H3 Fun-ControlNet:照片首帧 + 白膜线稿(重合度 0.872);或 VACE 深度 + 照片首帧 | 需要第三方控制权重;照片里有、网格里没有的动态主体在 VACE 里会消失 |
| 视频编辑(改材质、换风格) | Blender 里改材质,渲染首帧贴回动态主体,配原白膜跑 H3 ref2va | 首帧里的动态主体需要从原图贴回 |
七、第二个场景:彩色客厅
为了检验结论能不能推广,换一张颜色丰富得多的客厅照片(淡紫墙、奶白布艺沙发、红紫黄抱枕、人字纹地板、绿植、挂衣架)。没有视频可以自标定,视场角用 MoGe-2 估计(53.6°);Astra 建模 3 轮,物体 IoU 0.458 → 0.524 → 0.569,深度误差 2.3%,有一个物体悬空。沿同一条换朝向轨迹渲染白膜,照搬卧室上的 R3a 配方(官方格式、逐段时间、补帧)。
这个场景用另一种对齐指标:直接拿 Blender 的物体 ID 图当真值,按名字归成沙发、抱枕、地毯、边桌、挂衣架、书架、植物、海报、坐墩、窗帘十类,和生成画面里 SAM 3 的分割比 IoU。Astra 的彩色渲染自己也只有 0.704(SAM 3 在渲染图上本身就有漏检),可以当作上限。
| 组 | 物体对齐 | 开头 | 第一次左转 | 第二次左转 | 色彩度 | 灰像素占比 | 首帧 PSNR |
|---|---|---|---|---|---|---|---|
| 原版 H3 照片 + 白膜,种子 42 | 0.375 | 0.63 | 0.39 | 0.20 | 35.6 | 0.08 | 19.3 |
| 原版 H3 照片 + 白膜,种子 7 | 0.289 | 0.63 | 0.00 | 0.39 | 33.1 | 0.30 | 18.5 |
| 原版 H3 照片 + 白膜,种子 123 | 0.562 | 0.63 | 0.38 | 0.62 | — | — | — |
| 原版 H3 照片 + 白膜,种子 2025 | 0.364 | 0.61 | 0.20 | 0.30 | — | — | — |
| Fun-ControlNet 白膜线稿 | 0.597 | 0.68 | 0.37 | 0.66 | 33.4 | 0.25 | 11.1 |
| Fun-ControlNet 照片首帧 + 白膜线稿 | 0.623 | 0.67 | 0.49 | 0.67 | 36.7 | 0.10 | 29.0 |
| Fun-ControlNet 照片首帧 + 白膜深度 | 0.599 | 0.64 | 0.47 | 0.63 | 42.4 | 0.07 | 28.6 |
| 参照:Astra 彩色渲染 | 0.704 | 0.71 | 0.65 | 0.74 | 20.7 | 0.54 | — |
| 参照:白膜本身 | — | — | — | — | 3.1 | 1.00 | — |
- 同样没有照抄灰色:生成视频的色彩度 33–36,比 Astra 的渲染还鲜艳,照片里的颜色和材质都保留了下来,新露出来的左墙也是淡紫色、地板是人字纹。
- 原版 H3 的镜头跟随随种子波动:4 个种子的物体对齐 0.29–0.56(均值 0.40)。种子 7 的动作整体晚了一截,第 54 帧还没转过去,第 120 帧才转到左墙,按固定帧采样就算成了 0。这和卧室上「只给白膜」不稳定的现象一致。
- Fun-ControlNet 在这个场景同样最稳:照片首帧 + 白膜线稿 0.623,已接近 Astra 渲染自己的 0.704;首帧 PSNR 29.0 dB,色彩度 36.7,外观来自照片。
八、顺带:Claude Opus 5.5 和 GPT-6 Astra 谁建模更好
同样的 60° 标定输入、系统提示、反馈和评分,从零开始建 Blender 场景。
| 模型 | 物体 IoU(逐轮) | 深度误差 | 每轮耗时 | 费用 | 脚本长度 |
|---|---|---|---|---|---|
| GPT-6 Astra,4 轮 | 0.717 → 0.755 → 0.759 → 0.794 | 3.4–3.5% | 285–362 s | $3.82 | 688–1102 行 |
| Claude Opus 5.5,4 轮 | 报错 → 0.365 → 0.456 → 0.545 | 4.4–5.5% | 约 31 s | $0.50 | 123–139 行 |
| Claude 接着跑满 12 轮 | 最好 0.674 | 3.4–4.7% | 约 31 s | 约 $1.55 | 约 130 行 |
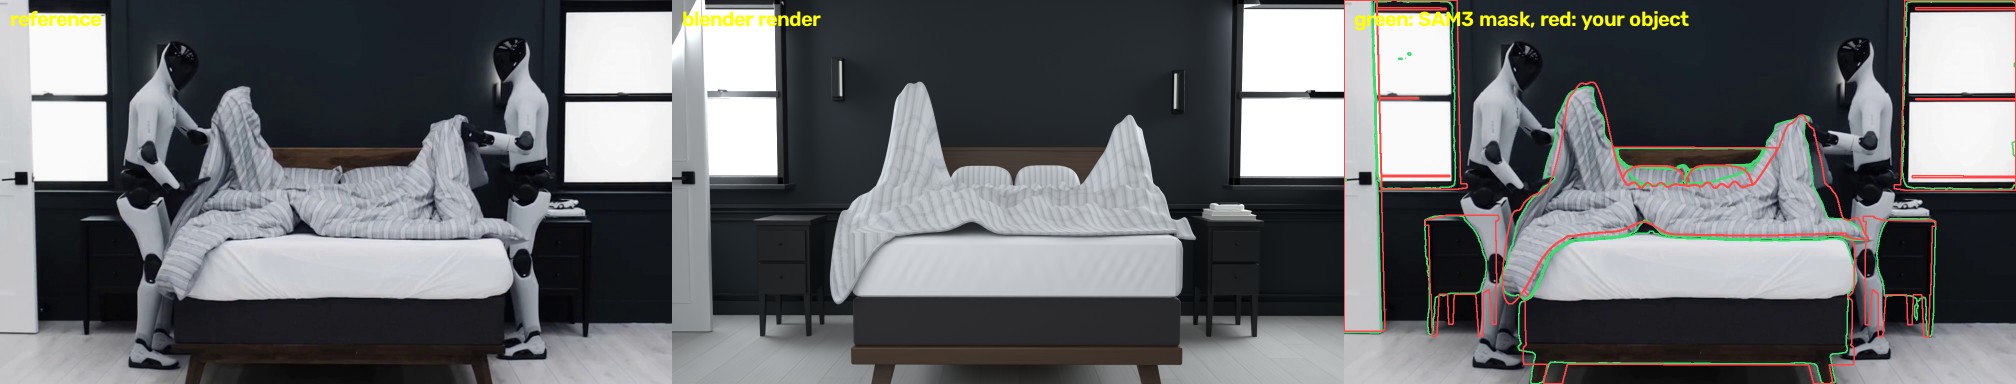
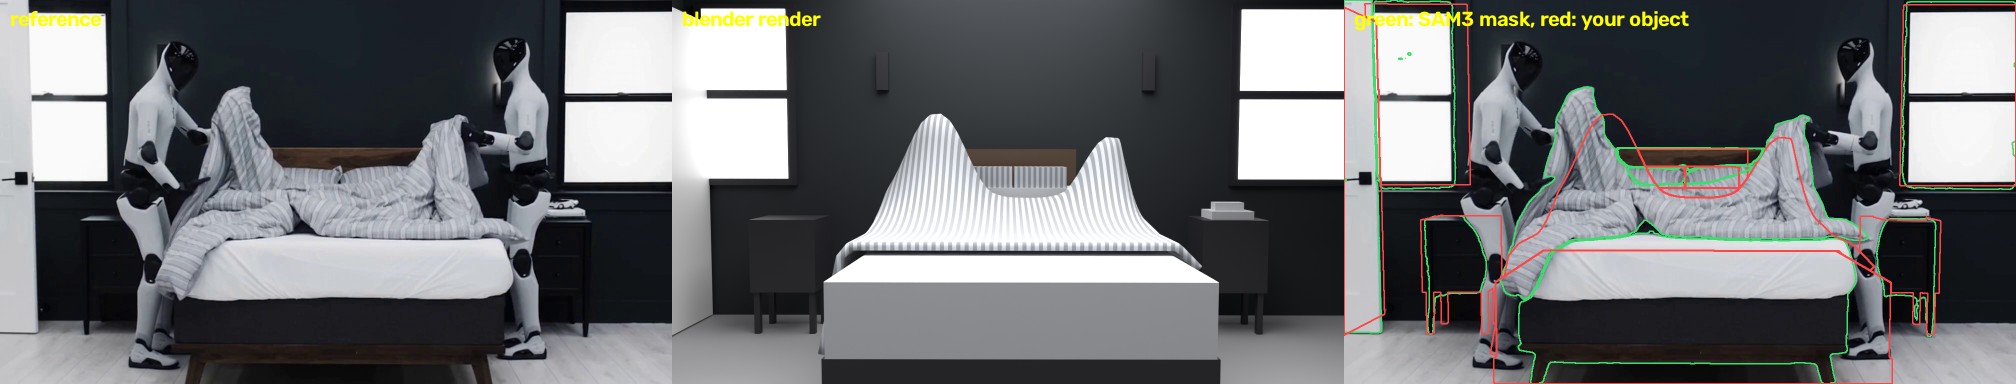
Astra 第 1 轮就超过了 Claude 12 轮的最好成绩;差距主要在细节量。Claude 快约 10 倍、便宜约 7 倍,适合快速迭代粗模。
九、方法与局限
- 所有实验都不训练任何模型;LingBot、SolarWM-H3 只改证据画面和注入方式,原版 H3 只改输入和提示词。H3 Fun-ControlNet 和 VACE 是别人训练好的控制模型,我们直接用。
- 重合度只看床、床头柜、窗、门、床头板五类物体,SAM 3 漏检时会偏低;转身过程中的过渡帧本来就很难对齐,所以看停留段更有意义。
- 原版 H3 每次 ref2va 单卡约 40–50 分钟,其余组的种子数不同:R3a 跑了 3 个种子,LingBot 关键组 3 个种子,其余多数 1 个种子。
- 机器人在网格里不存在:用白膜或网格铺满画面时,模型会把机器人当成不该有的东西抹掉;保留源视频投影的组合(LingBot 混合证据)能保住动态主体。